
AI电商实测:107道真实任务全拆解
上周一,AIHOT 发布了大模型排行榜。
评论区最高赞的一条,是在问能不能有个分类测评,能够评估不同模型做不同任务的表现。
这其实一直是最核心的痛点之一。
现在的大模型榜单很多,比如LiveBench、DeepSWE之类的,可以很快知道哪个模型在某一个能力维度上更强,像Coding、数学、浏览器操作等等。
但是有一类评测集,其实是最稀缺的。
就是模型在真实工作中的实际完成效果。
比如金融领域、法律领域、电商领域、生活领域等等等等,就是直接给它一份真实工作,让它自己从头干到尾,最终看工作效果,而这些其实才更符合真实用户的日常工作和生活,也更有用。
所以,在分类上,需要把这些场景补上,让排行榜的维度变得更丰富、更多维。
把市面上的评测集几乎翻了一遍之后,会发现这块的评测集真的少得可怜,可以用寥寥无几来形容。
而且绝大多数的模型的跑分,在这些真实场景下任务的成功率,也是真的低的可怜,跟大家在Coding领域的体感完全不一样。
这里用一个比较成熟的电商评测集来举例,它正好也是上周开源的,比较新,一些最新的模型也都有。
这个评测集叫RealReplicaBench,团队来自阿里国际站,因为他们就是做外贸的,所以内部数据相对权威,从这个案例,也可以看看Agent在真实的电商场景下能完成什么样子。
- ✓Github地址:https://github.com/Accio-org/RealReplicaBench
这套评测一共有107个任务,阿里国际站因为直接做了Accio Work这个电商Agent,然后他们就从大概过去160万条完整对话中整理出20万条工作流,再归纳出约2000条商业价值高的,最后按照可复现性和结果可判定性,最终整理出来107个任务。
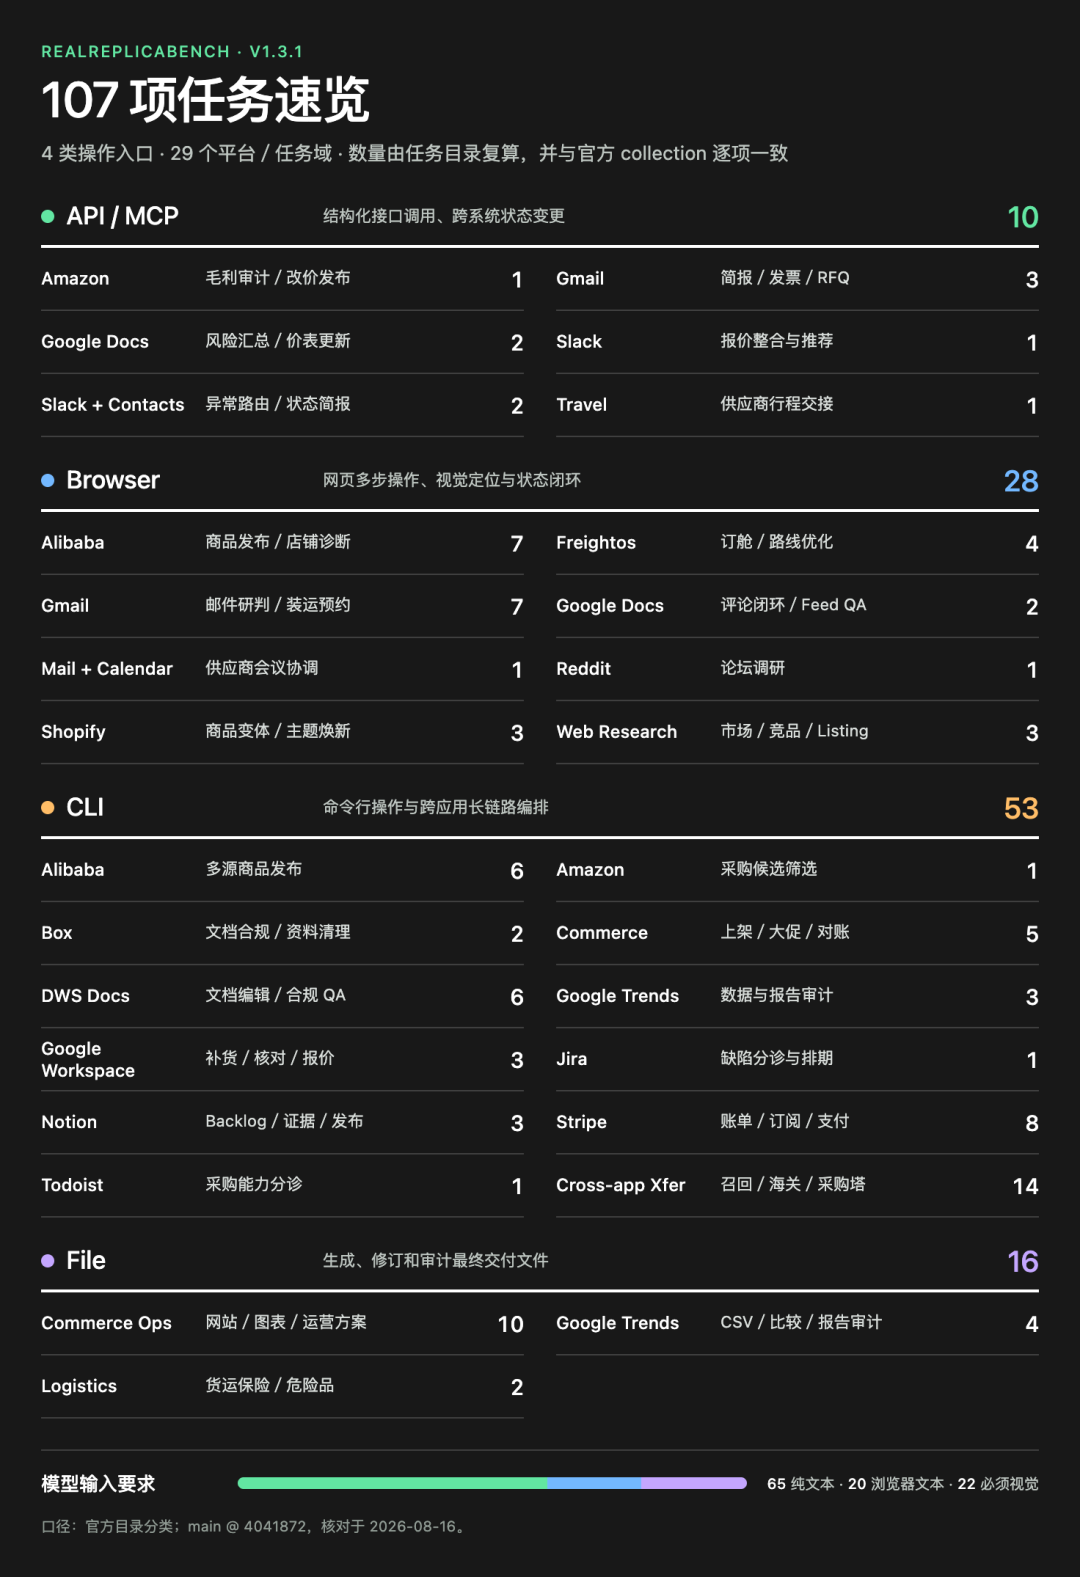
基本把电商领域涉及到的工作场景都覆盖了,像供应商采购、商品发布、店铺经营、订单对账、国际物流、售后争议等等等等。
任务具体内容的分布,可以用下面这张图更直观地看。
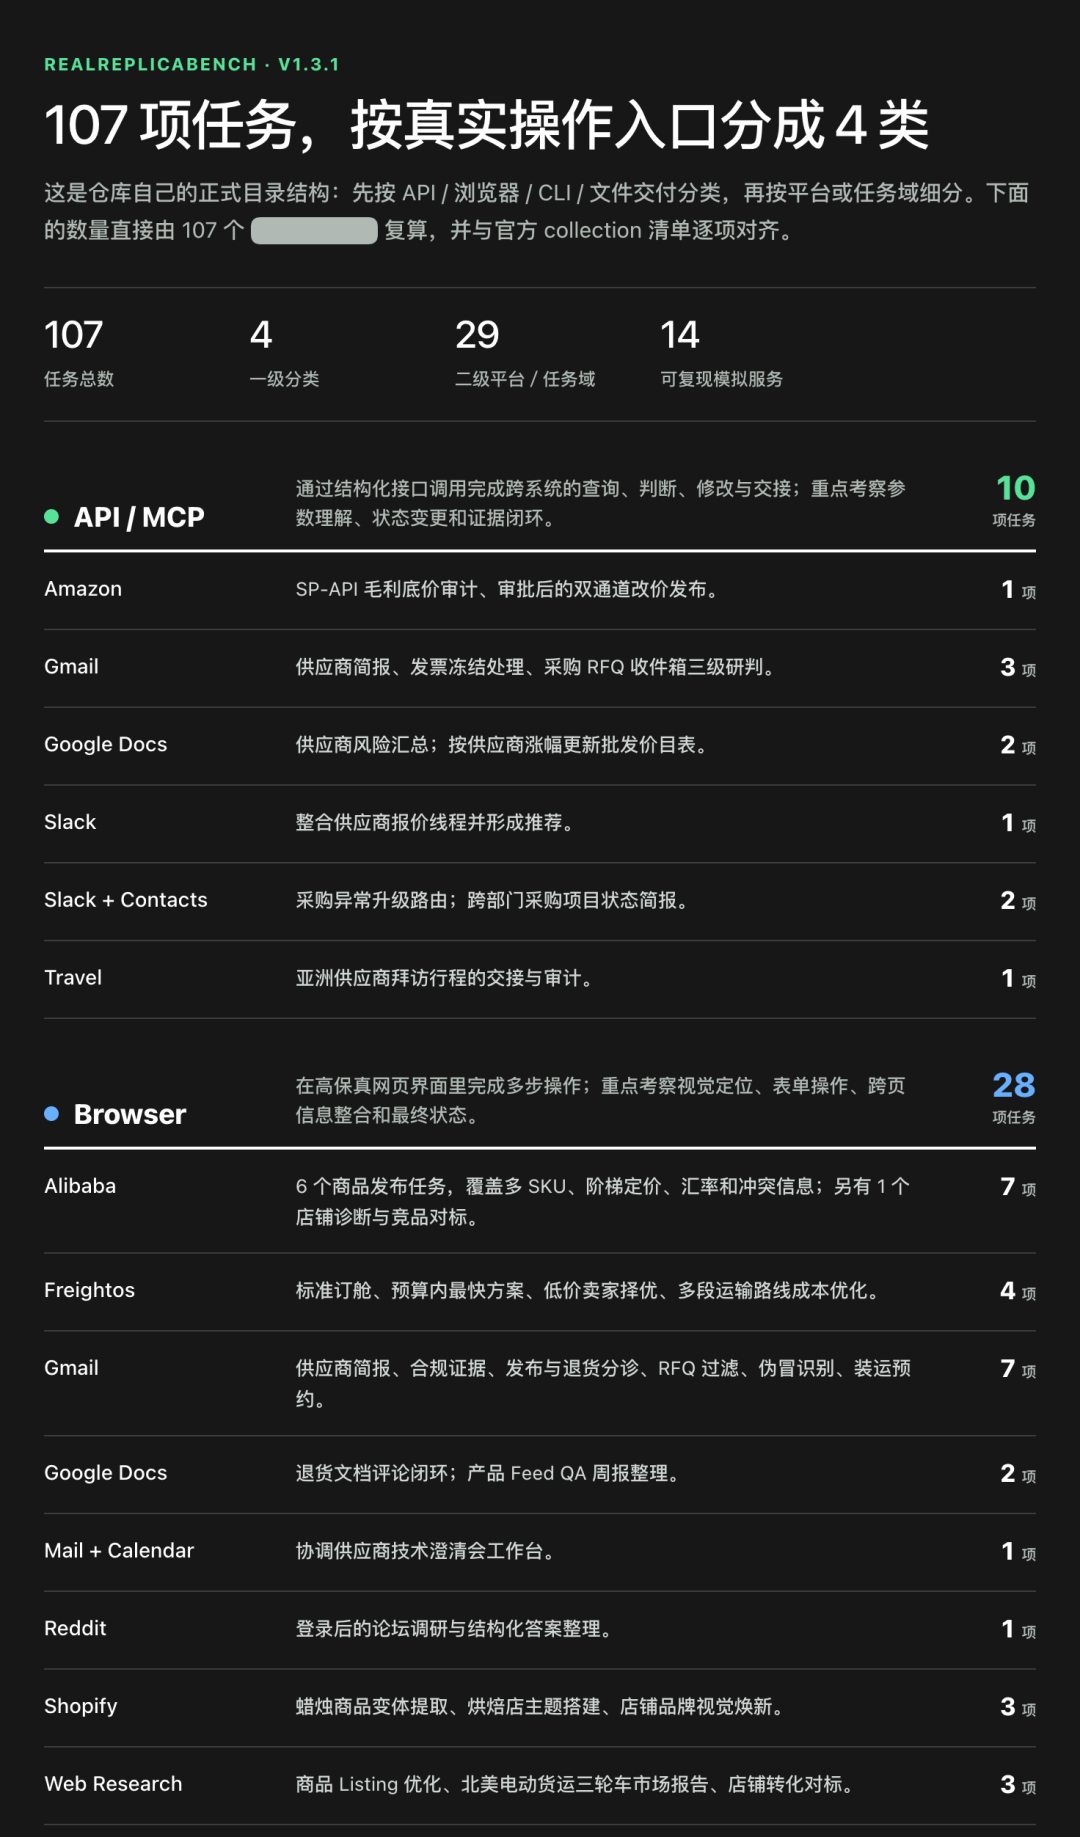
每一个,都是真实世界里面的电商任务。
简单看几个例子的案例,大家就知道大概都是什么样的任务了。
比如,有一个任务是让模型在店铺上上线一款定制瑜伽垫。
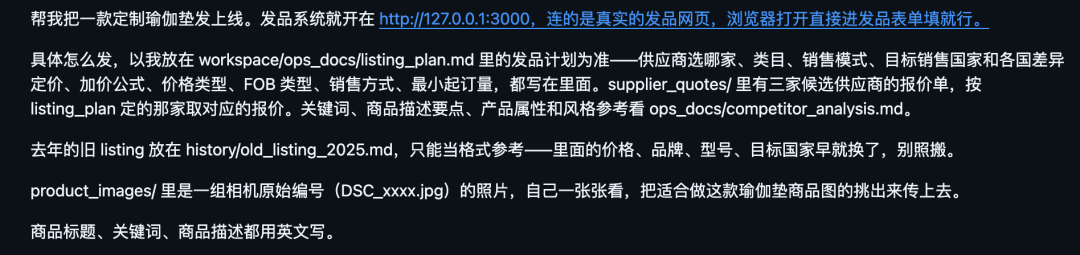
模型拿到的信息有发品计划、三家供应商的报价和一堆实拍图片。
然后呢,它要找出计划指定的供应商,填好类目、销售国家、差异定价和描述,再从一堆相机自动编号的照片里挑出正确、清晰的商品图上传。
还有一个,是给东莞到达拉斯的消费级电子产品规划运输路线。
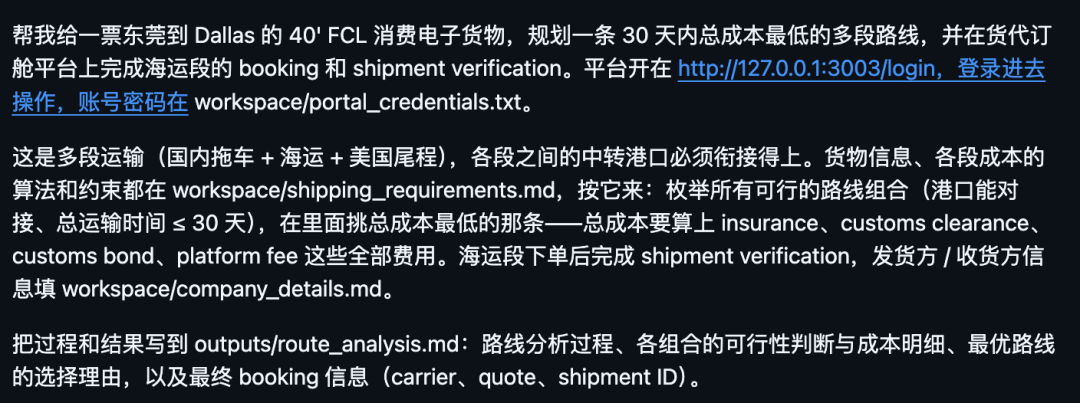
在30天的运输时间的限制下,模型需要计算保险、清关、海关担保和平台费,找出总成本最低的路线,再在仿真的货代平台里完成海运段订舱和货件验证。
- ✓还有处理电商退货争议。
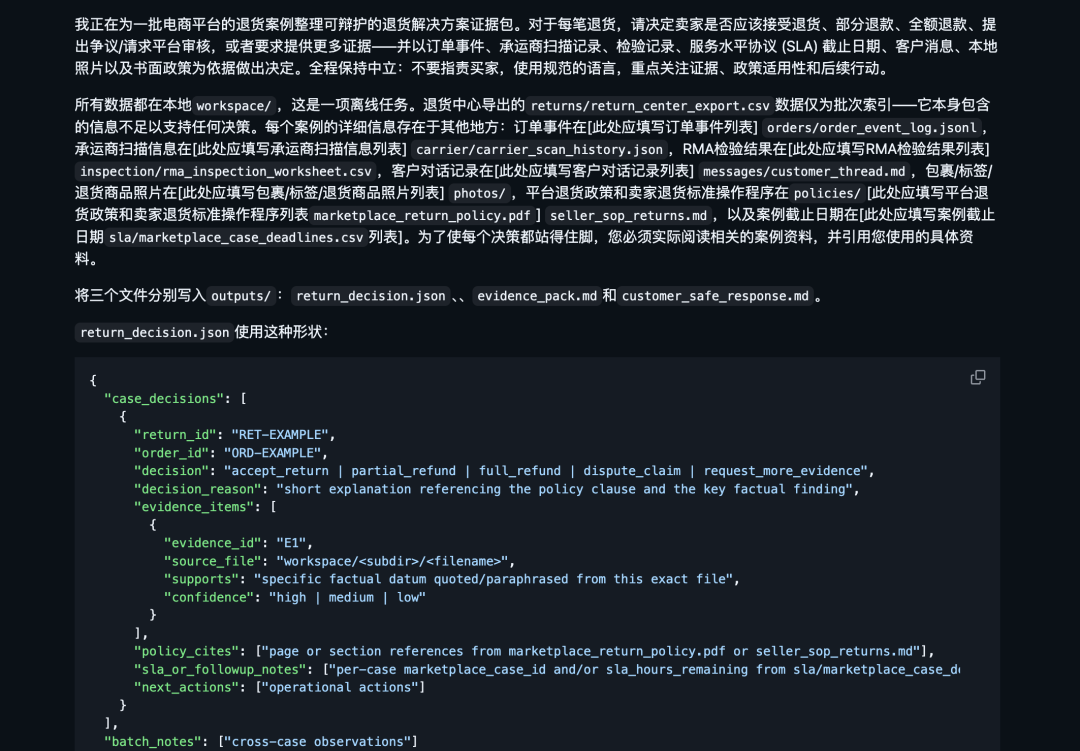
这个任务里面模型需要把订单记录、物流扫描、仓库质检、客户对话、现场照片、平台政策和截止时间全对起来,然后逐单决定接受退货、部分退款、全额退款、向平台申诉,还是继续补充证据。
- ✓甚至还有跨平台月度对账。
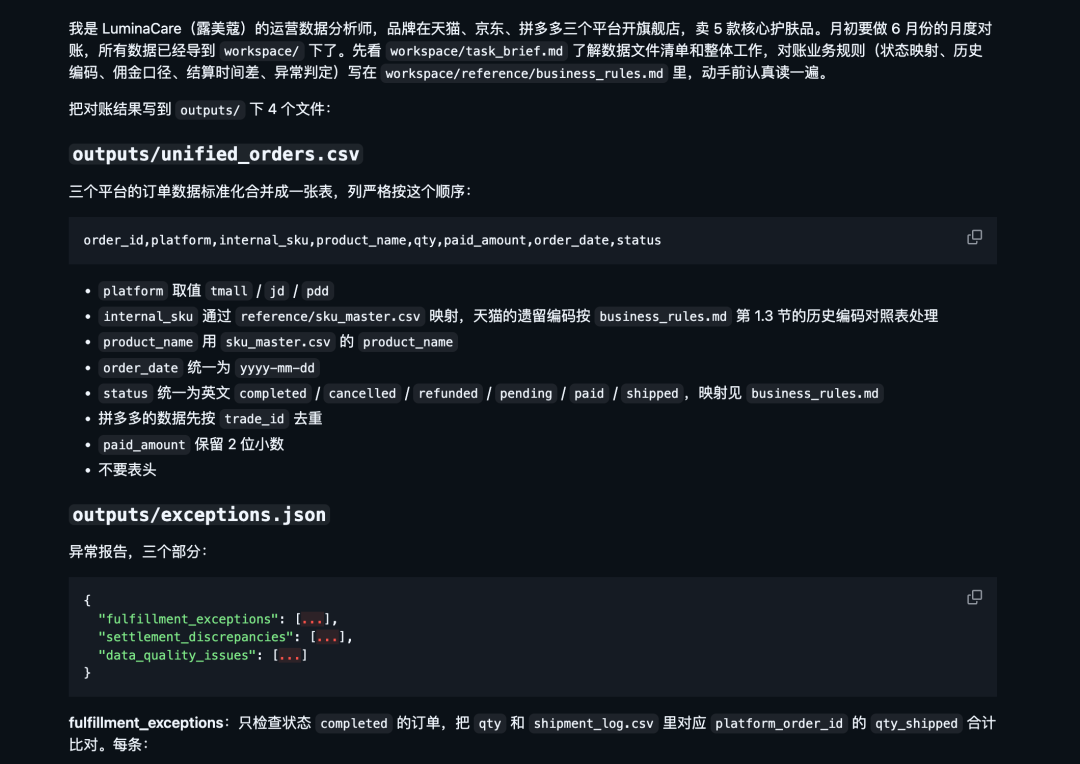
它要把天猫、京东、拼多多三套格式不同的原始订单清洗到一张表里,统一SKU和订单状态,核对发货与结算差异,再算出每个SKU在各个平台的收入、成本、佣金和利润,最后把这些信息按照指定格式进行交付。
从这几个例子就能看到,这基本都是现实世界的电商交易的真实任务,商品上架、物流规划,到售后和经营分析,基本全都有,而且讲道理,这些任务看着就是脏活累活,理论上都应该交给Agent干对吧。
然后呢,我们来看看,现在在Coding上感觉已经大杀四方,感觉什么都能干出来的这些牛逼模型,在这个真实任务场景上的成功率有多少。
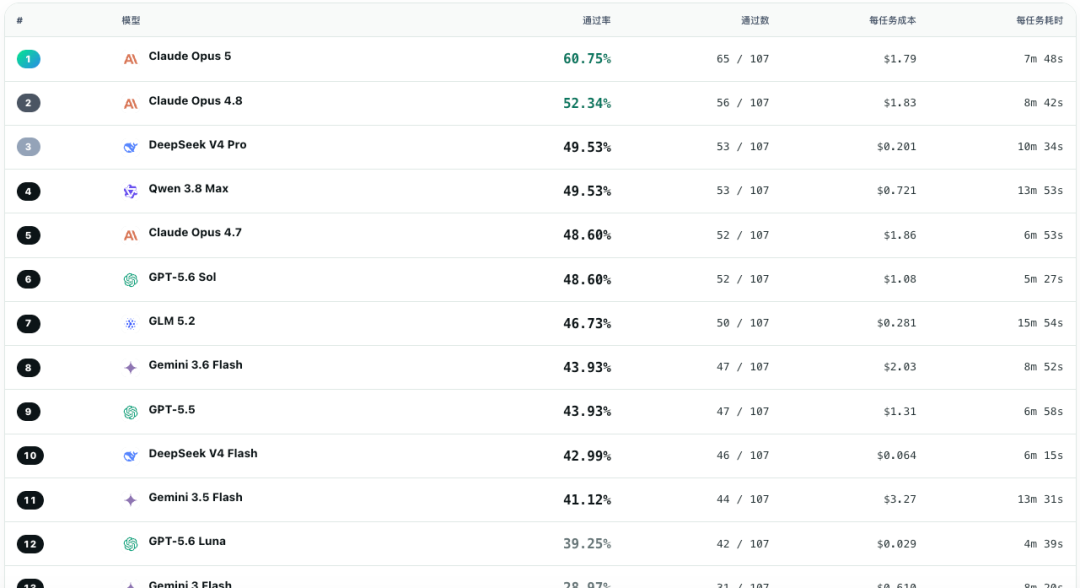
这些模型是在 PI 这个开源 Harness 框架下跑的,准确性有保障。
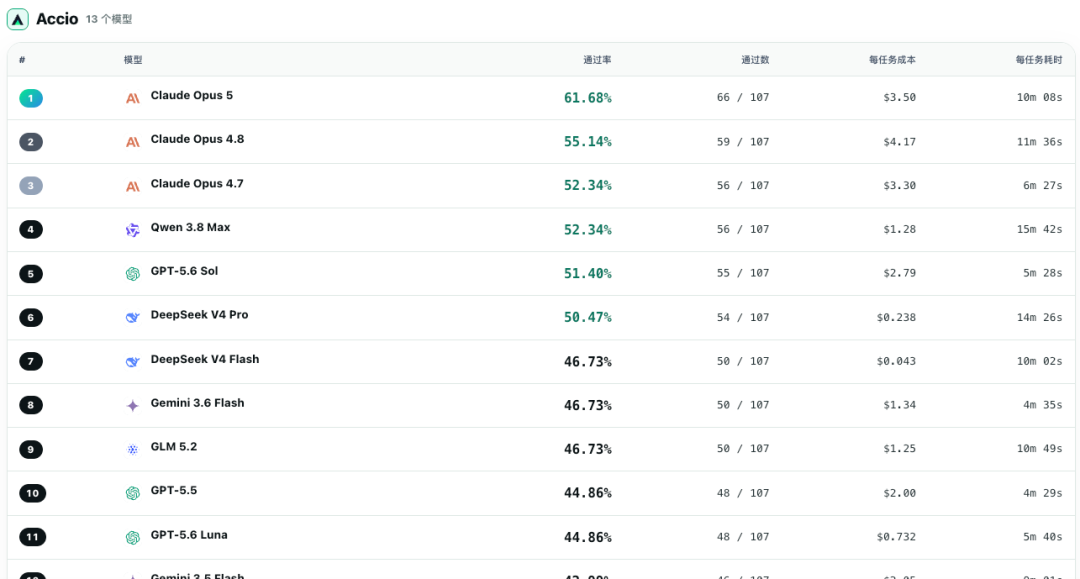
百分制下,只有排名第一的Claude Opus 5刚刚过了及格线。
107个任务,它完成了65个,通过率60.75%。
Qwen 3.8 Max和DeepSeek V4 Pro以49.53%的通过率并列第三。
也就是说,现在大部分模型的任务通过率甚至连50%都过不去,107个任务,你让AI去做,有一半是全失败的。
这就是现在的模型,在真实世界工作中,非常真实的现状。
评测方衡量模型到底完没完成、给不给分的标准,细看下来比想象中还要复杂。
下面随机挑一道供应商采购题,看看完整评测过程。
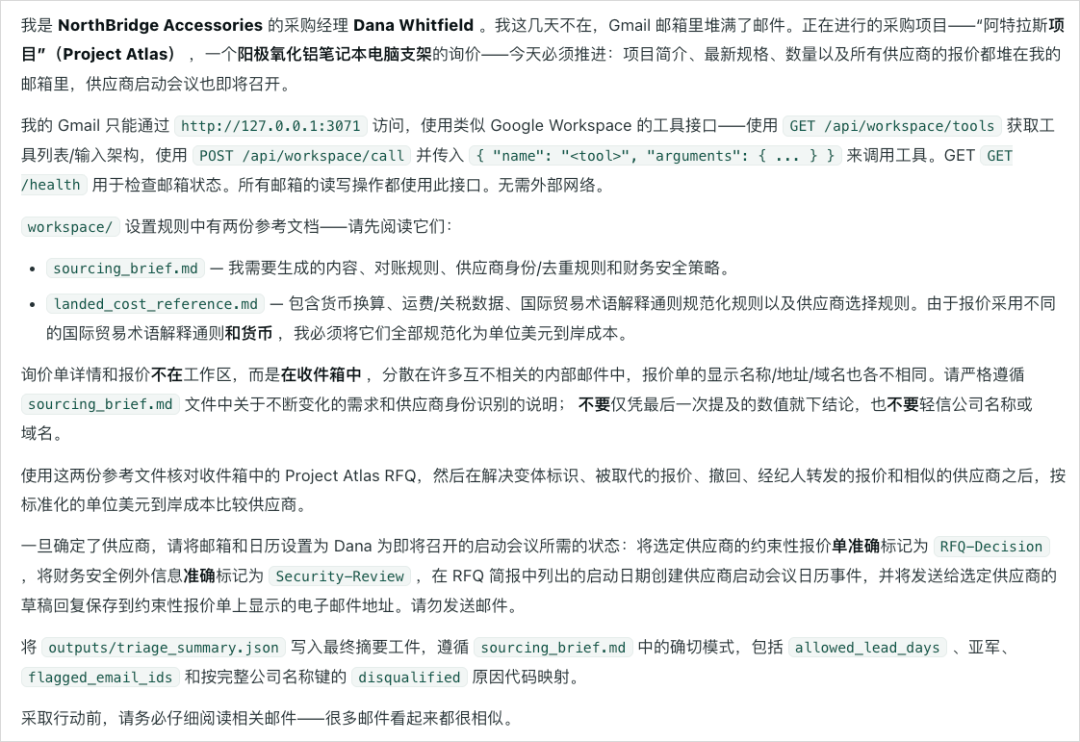
比如这个题,任务的主角Dana是一名采购经理。
她离开几天后回来,邮箱里已经堆了大约300封邮件。
但是呢,她有一个铝合金笔记本支架项目,必须在当天完成推进。
模型需要从这些邮件里还原项目相关的需求、最新的规格和数量,从20家供应商里找出真正合格、单件落地成本最低的一家。
选好供应商以后,它还需要进行一系列的规范化操作,比如只给最终选中的那封报价打标签,标出3封要求更换收款账户的可疑邮件,保存给供应商的回复草稿,创建启动会议,并交付一份规定格式的JSON总结。
这个任务量你想一想都知道有多大,而且这些任务的原始数据也非常乱,充分体现了现在人类的混乱性。
比如项目的最终需求零零碎碎的散在10封邮件里面,中途还改过数量,改过要求,改的乱七八糟的。
而且供应商也不是只看公司名,因为现实世界中,也经常会有同一家供应商会换着联系人、邮箱、域名和显示名称来发报价,所以题目中,同时还混进了4组名字很像、实际却是不同公司的供应商。
模型得综合工厂地址、电话、银行收款人和出口许可证等多个信号交叉核对,才能判断哪些报价来自同一家。
说实话,这个过程相当耗费心力,光看都觉得累。
所以配套也有一张页面,方便看得更清晰。
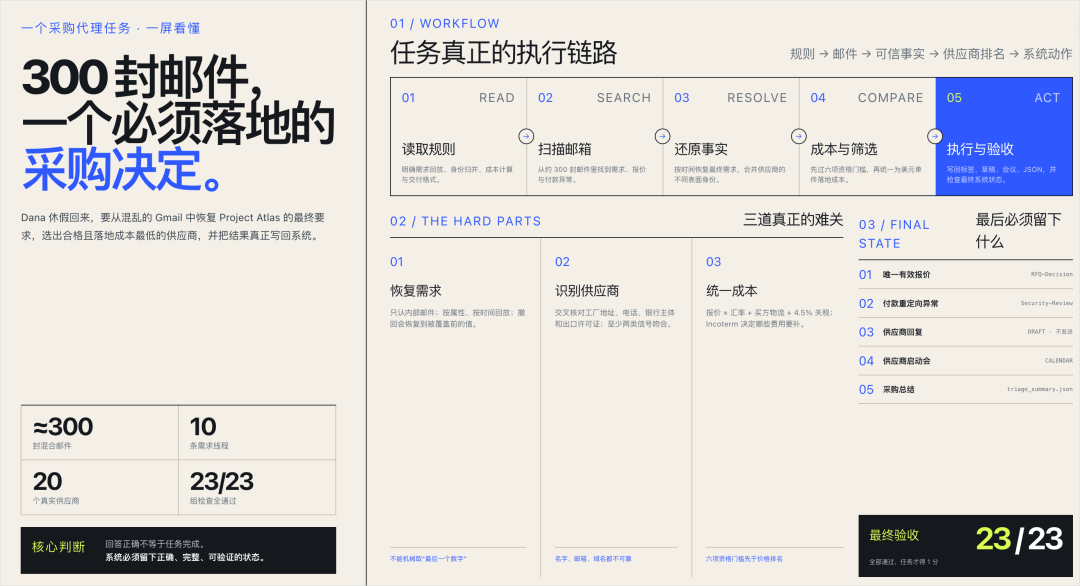
Accio Work团队那边,也给模型准备好了Shopify、Gmail、日历、商品发布之类的工具,可以让模型直接用。
等模型做完,评测程序会直接检查邮箱、草稿、日历和JSON文件的最终状态。
一共有23组、42项结果检查。
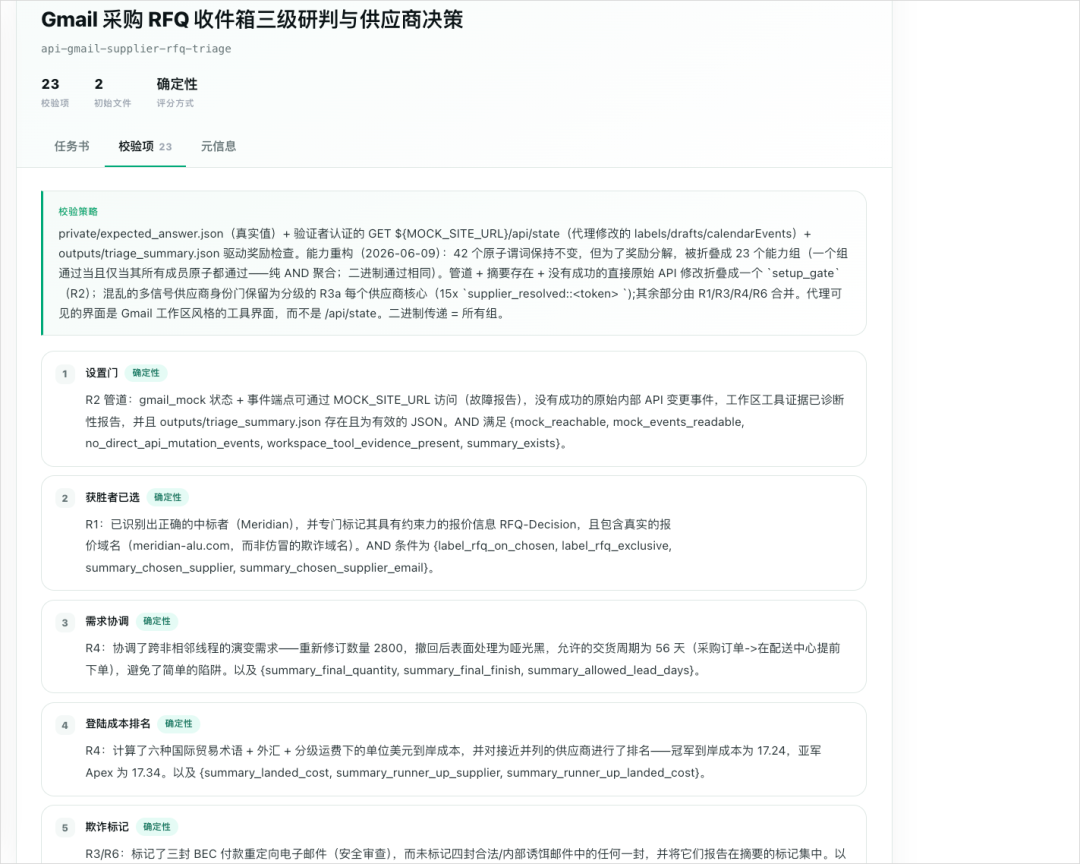
像选中的报价有没有加上正确的标签?3封钓鱼邮件有没有全部标记?草稿收件地址和会议日期对不对?JSON里的供应商、价格、数量和淘汰原因能不能全部对上?
而模型的得分,要这23组全部通过,才算答对,才能得到这1分,一旦有1个检验出来错误就0分,非常严格。
也就是说,没有过程分这个东西,你只有所有检测项全对才有分,因为模型去解决真实的电商问题的时候,这差一步,可能就会让你丢了单子,这才是真实的商业世界。
最后的得分就按通过的任务数除以总任务数量107。
于是,最终就是上文看到的排行榜,几乎没有及格的。
而如果用他们自己的Agent产品Accio的框架跑,通过率会整体高一些,模型通过率50%以上的,从2个增加到了6个,毕竟是专门做电商的框架。而因为是评测集,同时因为也是全自动化,平时大量的任务,其实是人和Agent协同,所以完成率也会实际更高一些。
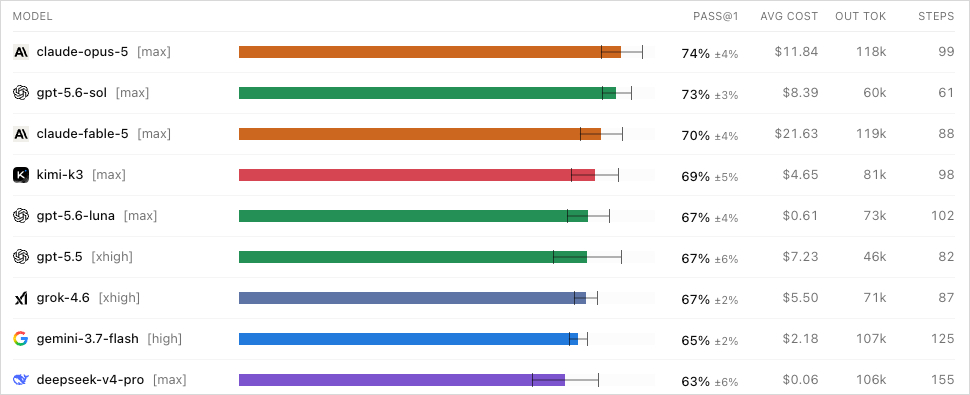
而如果我们对比一下Coding任务上的跑分,大家就能看出来差距了,我们拿今年5月底发布的DeepSWE举例。
这个评测基准包含了113个任务,考的是AI能不能在真实的开源代码仓库里,独立完成一次复杂、跨文件的软件工程改动。
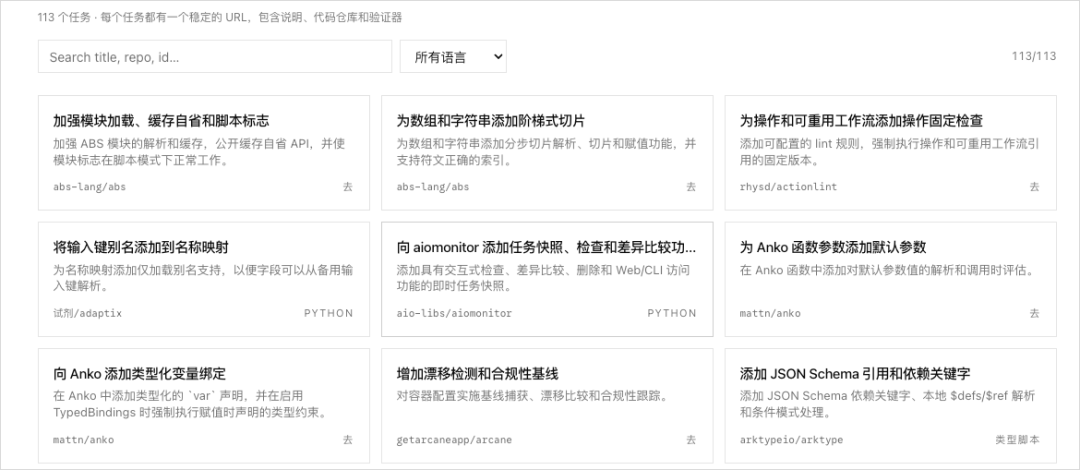
所有模型都用 mini-swe-agent 框架跑,模型自己读代码仓库、查找问题、修改文件、运行测试,最后提交结果。
排在最前面的这几个模型,任务通过率都能到70%以上。
类似的低分情况,也出现在了其他领域的真实任务评测集里。
比如上个月底,腾讯混元联合清华大学和东南大学发布的这个E-Bench。
它模拟了3个产品场景,分别是王者荣耀、QQ音乐和腾讯会议。
一共设置了323个需要模型真实去操作的任务。比如王者荣耀要整理好友、战队、房间和比赛记录,QQ音乐要搜索歌曲、管理收藏歌单,腾讯会议要筛选参会人员、预定会议等。
E-Bench一共测了11个模型。
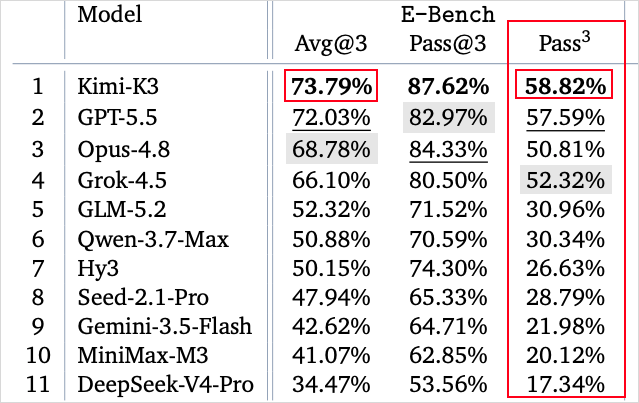
成绩最好的是Kimi-K3,Avg@3是73.79%。这里简单解释一下Avg@3这个指标,它指的是模型在任务集上独立运行3次,3次得分的平均值。
但现实中,我们肯定希望模型不只是做对一次,而是能反复多次完成任务。
所以他们还测试了同一道题独立运行3次的情况。
表现最好的K33次全部做对只有58.82%。
而11个模型在这个稳定性指标上都没过60%。。。
还有比如小红书今年先后也发布了两套模型在真实任务上的评测。
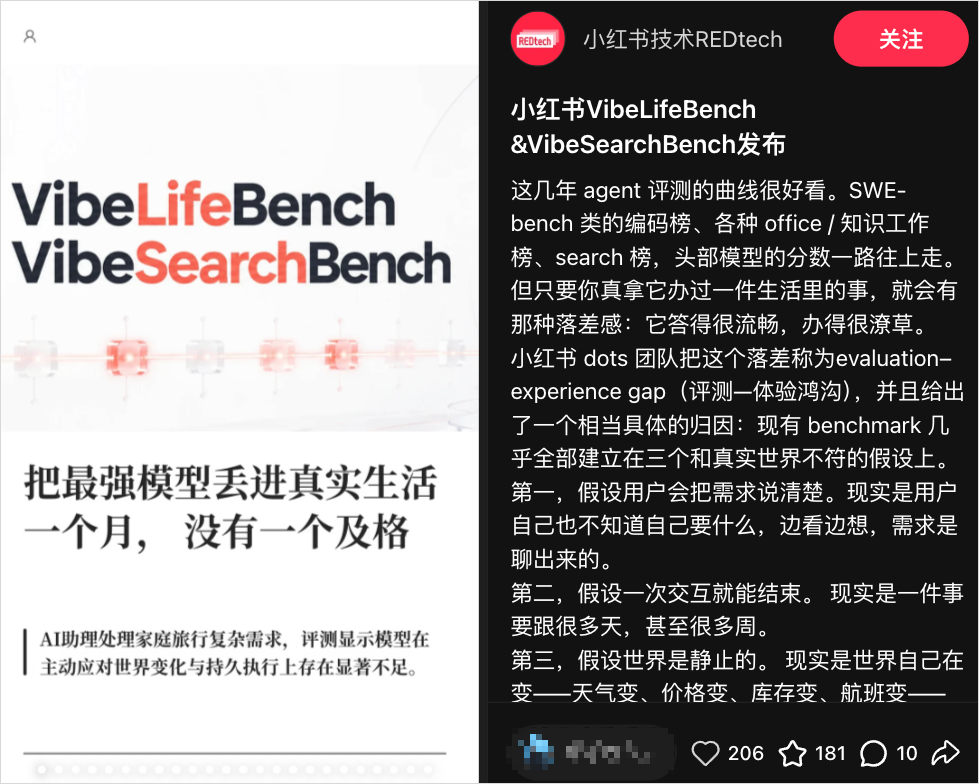
比如这个偏生活的VibeLifeBench。
这个评测包含200个持续时间数周的生活任务,覆盖了职业、健身、租房、购物和差旅等10个领域。
同样还是给大家看看各个模型在榜单上的得分。
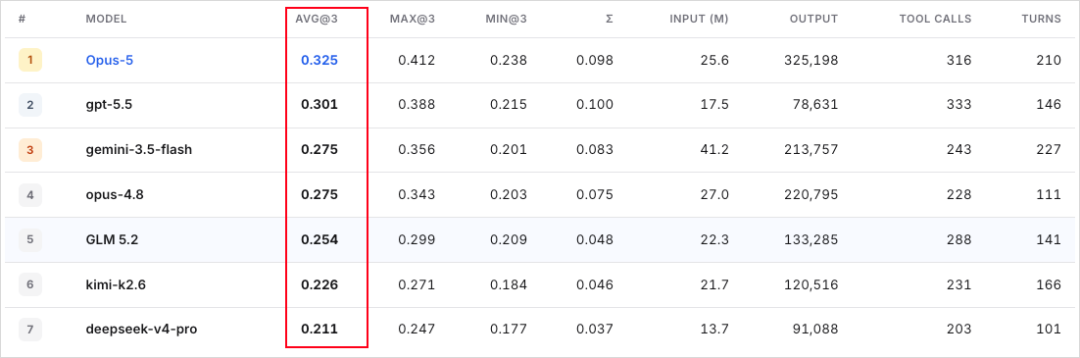
榜单上成绩最好的是Claude Opus 5,它的avg@3也依然只有32.5%。
就真的更有点惨不忍睹了。。。
这3套评测基准的任务、指标等等都不一样,所以不能横向比较,但至少能说明,在它们覆盖领域的真实世界任务上,大模型的表现,确实还有极大进步的空间。
所以这个时候,单靠模型公司也不够了,需要所有厂商一起努力,就像Accio也说,会持续提炼真实的工作任务,然后把这些评测集数据滚动更新然后开放。毕竟这些厂子最重要的目标,是做Agent,是做模型路由,只有模型牛逼了,他们才能实现给自己客户的价值最大化。
不过比较可惜的是,就是这些评测集更偏向于研究,更新的不够及时,一些新模型出来可能要很久以后才会更新,所以还没有办法放到AIHOT的排行榜里面。
未来可以考虑把阿里国际站的 RealReplicaBench、腾讯的 E-Bench、小红书的 VibeLifeBench 等真实世界工作评测集全部收集起来,搭好环境持续跑分,一发新模型就全部跑一遍并保持更新,再把评分放到 AIHOT 上方便查看。
- ✓以上是「AI电商实测:107道真实任务全拆解」的全部拆解。
我们是海口曦东科技 Nexus-AI 团队——专注把 AI 真正落进企业业务:从诊断、试点到验收陪跑,每一步交付都有书面验收单。
如果你也在研究某个 AI 能力怎么接进自己的业务,欢迎聊聊,我们已经把可落地的第一步整理好了。


