用 Codex 把 n8n 工作流转成 Skill:跨境电商案例
做一个skill让Codex原地复活所有n8n
- ✓划重点
- ✓TikTok
视频生产、SHEIN的邮件
- ✓Agent
等等确实全靠n8n跑出来的。
从Agent时代起来之后,从OpenClaw到Codex,n8n自己的官方社区论坛都有人在问「n8n是不是真的要死了」。定时、触发、自动跑,这些Codex现在都能做了。
- ✓划重点
n8n劝退很多人的,从来不是「能不能自动化」,是「太难了」:节点怎么配不会,凭证授权要单独学一遍,参数从上游传到下游对不上就断链,调试起来比写代码还费劲。这个门槛,对普通人来说一直太高。
- ✓划重点
但门槛高不代表这些工作流没用,而是可以变成Skills的原料。
这是官方公开的工作流模板库,10000+个工作流,背后是几年时间、无数人踩坑积累下来的自动化逻辑。就算n8n这个界面真的被时代淘汰,这些工作流背后的自动化逻辑没道理跟着一起死。而且谁都能看,谁都能拿,包括AI。
一个元技能先让Codex学会判断
先解释一下:技能是一个打包好的能力,Codex碰到对应的请求就会调用它,审计网站是一个技能,写Listing文案是一个技能,每一个都只认自己那件事。
- ✓划重点
而元技能不干这些具体的事,它干的是"造技能"这件事本身。给它一个n8n工作流链接,它的工作不是把这个工作流的逻辑跑一遍,是把这个工作流拆解、判断、转化成一个新的、独立的技能。
- ✓划重点
- ✓简单说:技能解决一个问题,元技能造出能解决问题的技能。
- ✓划重点
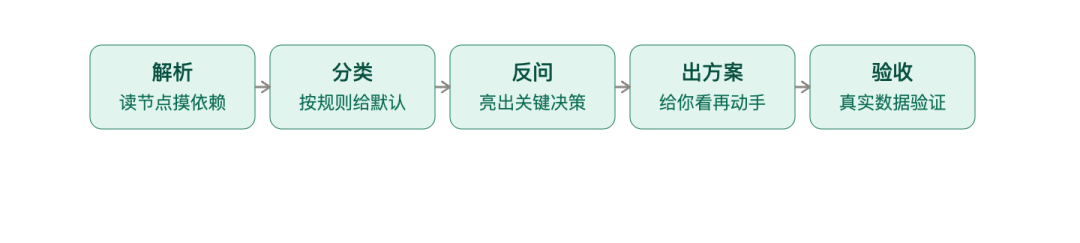
- ✓具体分五步:
——读工作流,摸清楚有哪些节点、每个节点在干嘛、依赖了哪些外部服务
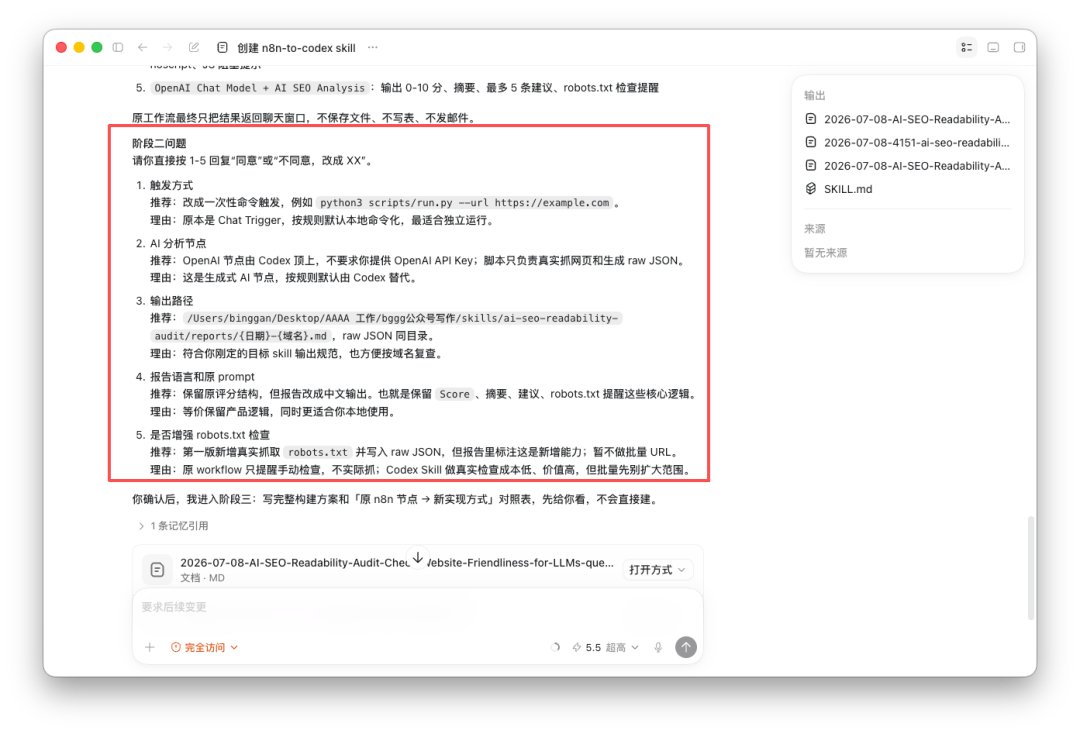
——把每个节点归进几个固定类别:生成式AI节点、存储协作节点、触发节点、人工审批节点等等,每一类都有一条默认处理规则
——不自己拍板,把关键决策亮给人看,附带推荐方案,人回答同意还是要改
- ✓出方案
——拿真实数据跑一次,不许拿编的结果糊弄过去
- ✓划重点
这套流程最后落地成了一个专门的元技能:n8n-to-codex-skill。它自己不干活,它的工作是教会Codex怎么把别的n8n工作流变成技能。
- ✓11 个
节点分类规则,复活任一工作流
这个元技能完整的skill.md有好几千字,这里就不整个贴了,放圈子了。
- ✓划重点
- ✓先摘最有信息量的骨架:
- ✓默认推荐
- ✓生成式AI/内容生成节点
LLM文本生成、图像生成、语音生成
Codex顶上;图像/视频生成先确认Codex有没有对应能力(额度),没有再问是否保留外部API
- ✓爬虫节点
无认证HTTP请求,抓公开网页、公开RSS
脚本直接实现,不需要Key;甚至
- ✓外部节点·付费数据服务
- ✓GSC、Exa.ai
- ✓[1]
、DataForSEO、Airtop
保留外部调用,必须用户提供凭证——真实数据,编不出来
- ✓外部节点·存储协作工具
Sheets、Notion、飞书、Gmail发送
默认建议本地化,问是否保留原集成
- ✓触发节点
Webhook、Chat Trigger、表单、定时/Cron
默认改一次性命令,问是否保留定时/常驻
- ✓数据转换/整形节点
Set、Code、Edit Fields
原样保留逻辑,脚本直接实现
- ✓控制流/分支节点
IF、Switch、Merge、Loop、Wait
- ✓原样保留逻辑
- ✓人工审批节点
sendAndWait、Slack审批
- ✓问是否保留人工确认步骤
- ✓子工作流调用节点
Execute Workflow
递归解析被调用的子工作流,不能跳过
- ✓错误处理/重试节点
Error Trigger、Stop and Error、节点自带Retry
保留错误处理意图,用try/except实现
- ✓文档/注释节点
- ✓Sticky Note
转写进SKILL.md,不参与运行
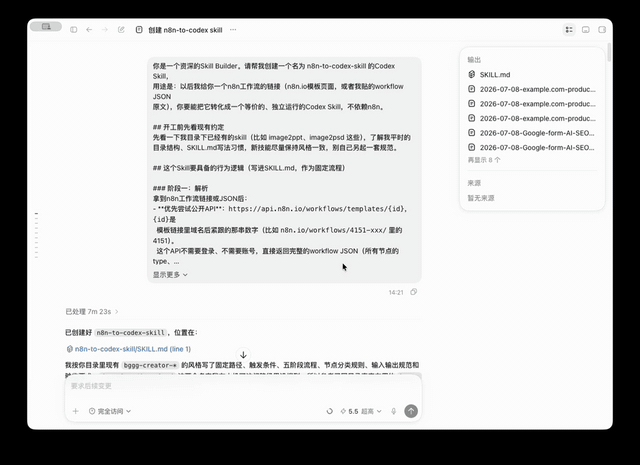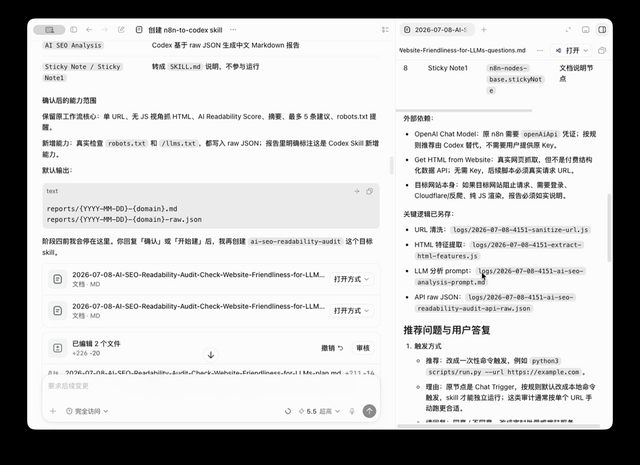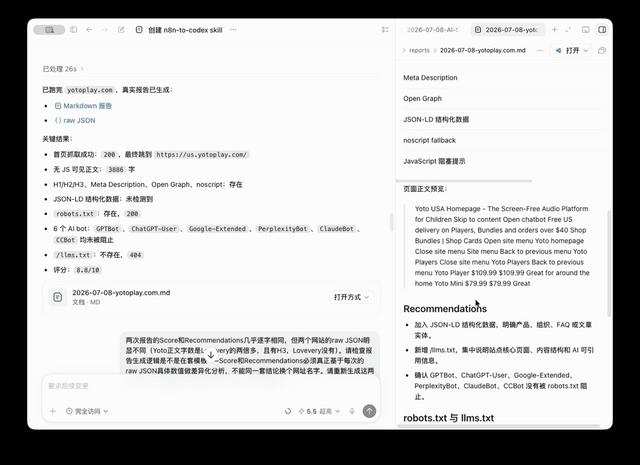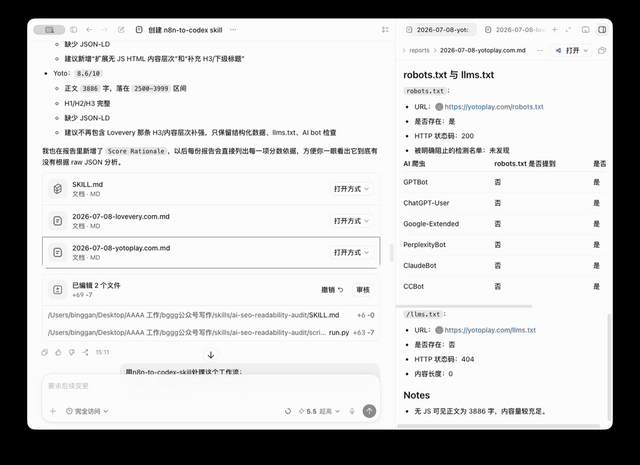
不过再多的规则也只是设计。真正顶不顶用,得拿真实的n8n模板跑一遍才知道:分类对不对,反问准不准,最后跑出来的东西能不能用。
先看下面 SEO & GEO 场景的两个实战Case。
丢一个网址,SEO审计的问题摆在前
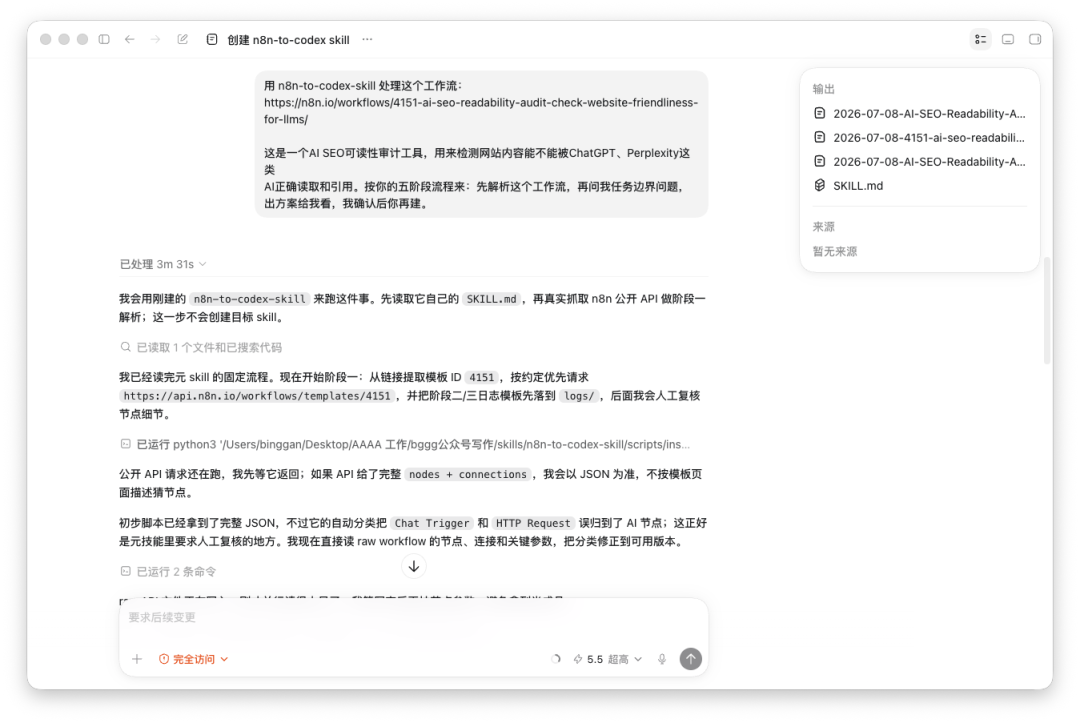
这里审计skill的复刻对象是n8n模板库里的4151,地址传送:https://n8n.io/workflows/4151-ai-seo-readability-audit-check-website-friendliness-for-llms/
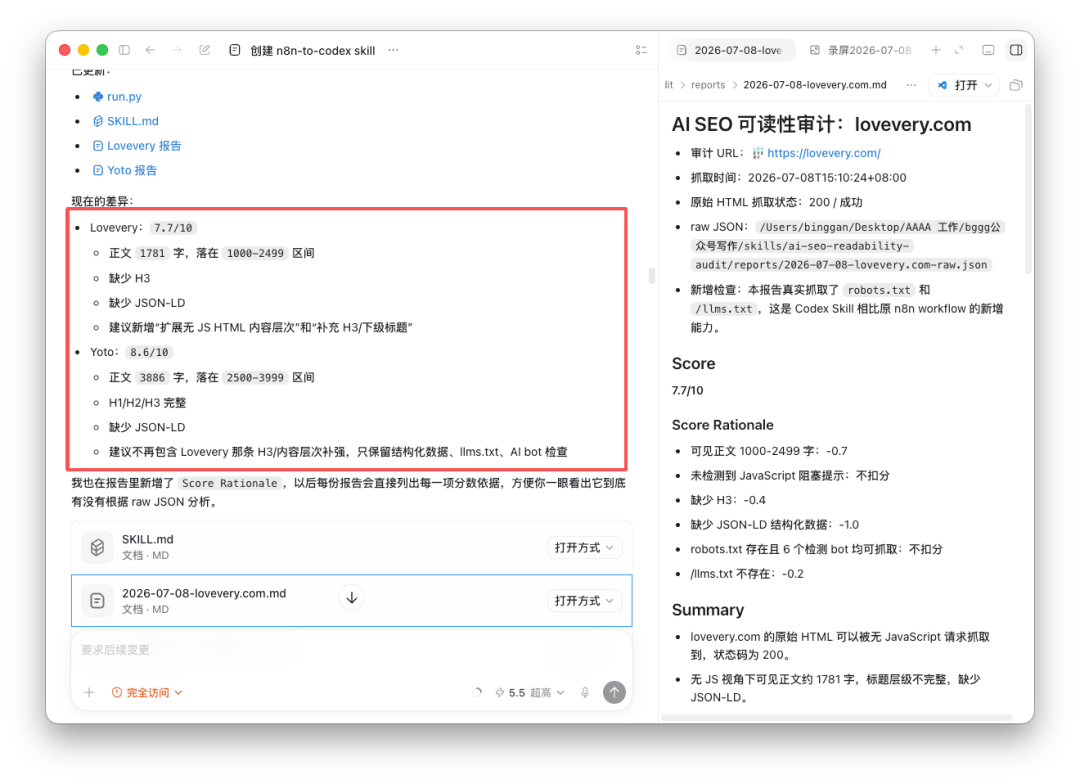
这个工作流一共六个节点,大概干的事是:给一个网址,然后爬虫抓取原始HTML,提取可见文本、标题层级、meta信息等等这些特征,再让AI打分——0到10分,可读性有多少,然后输出几条修复建议。
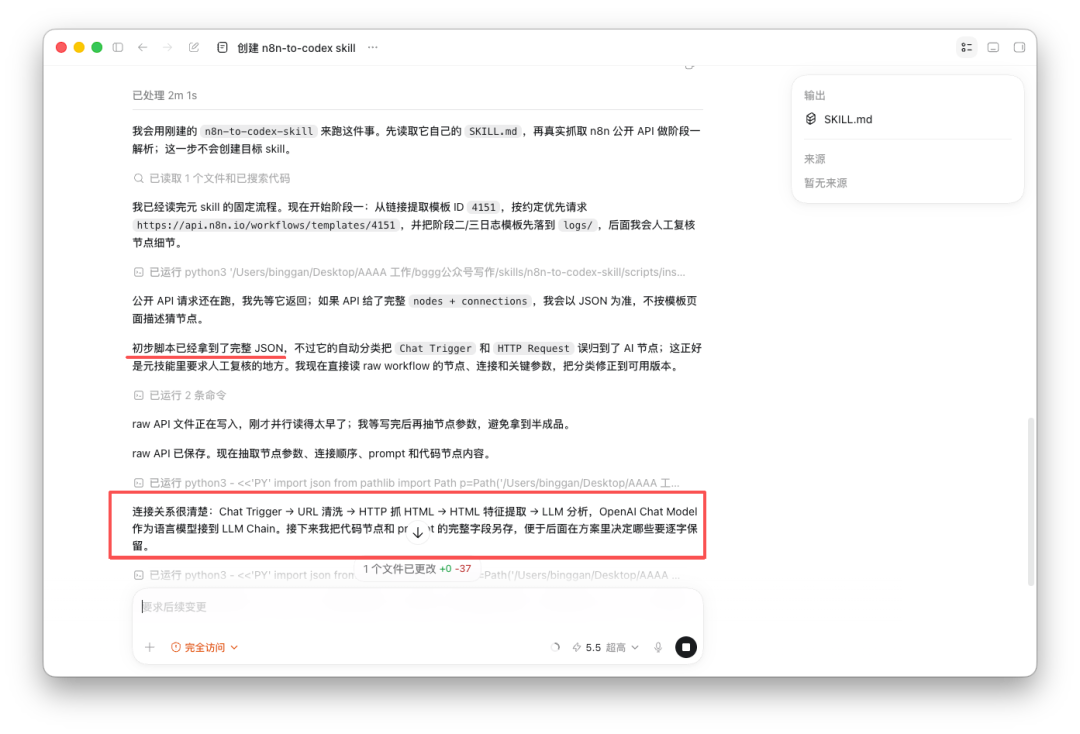
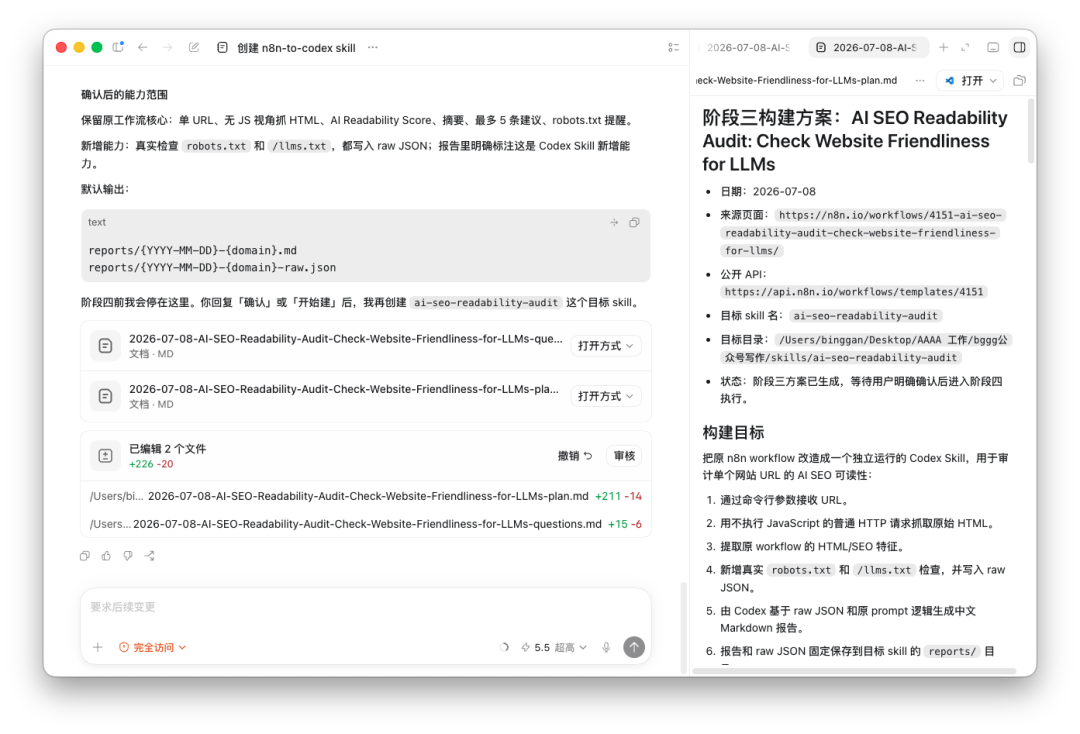
跑通了,看到 200 心情很美好。Lovevery打了 7.7 分、另一个打了 8.6 分,更有意思的是robots.txt检测结果:六个AI爬虫,两个网站全部放行,而llms.txt返回404。
GEO内容当场写,但有个局限
这一个skill复刻自8768,n8n模板库地址是:https://n8n.io/workflows/8768-google-form-ai-seo-geo-optimization-human-approval/
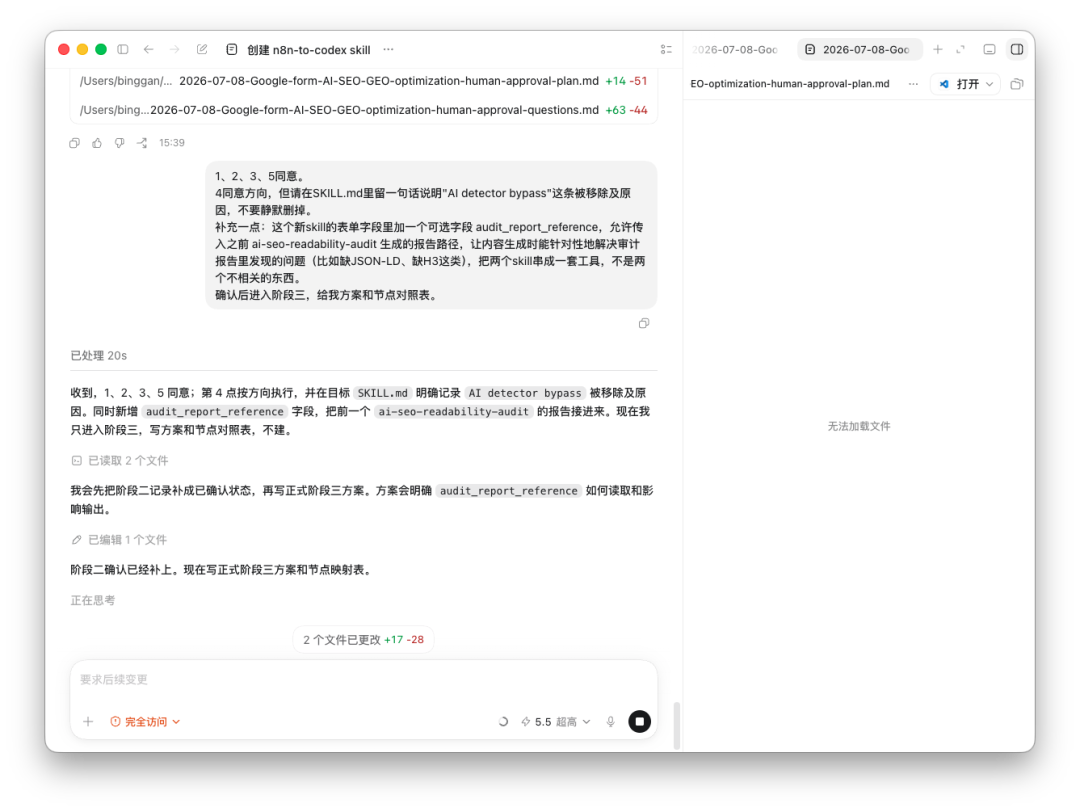
原模板是这么运作的:表单收集需求,AI生成内容,Gmail人工审批,Google Sheets记录状态。但表单收集的字段其实是一套技术博客案例模板,为了适配跨境中的产品页,直接把字段拆成页面类型、卖点、目标人群等等。Gmail审批也去掉了,改成本地人工确认,不用再接一个邮箱账号。
- ✓划重点
只要逻辑对,可以复用任何场景。
- ✓注意!
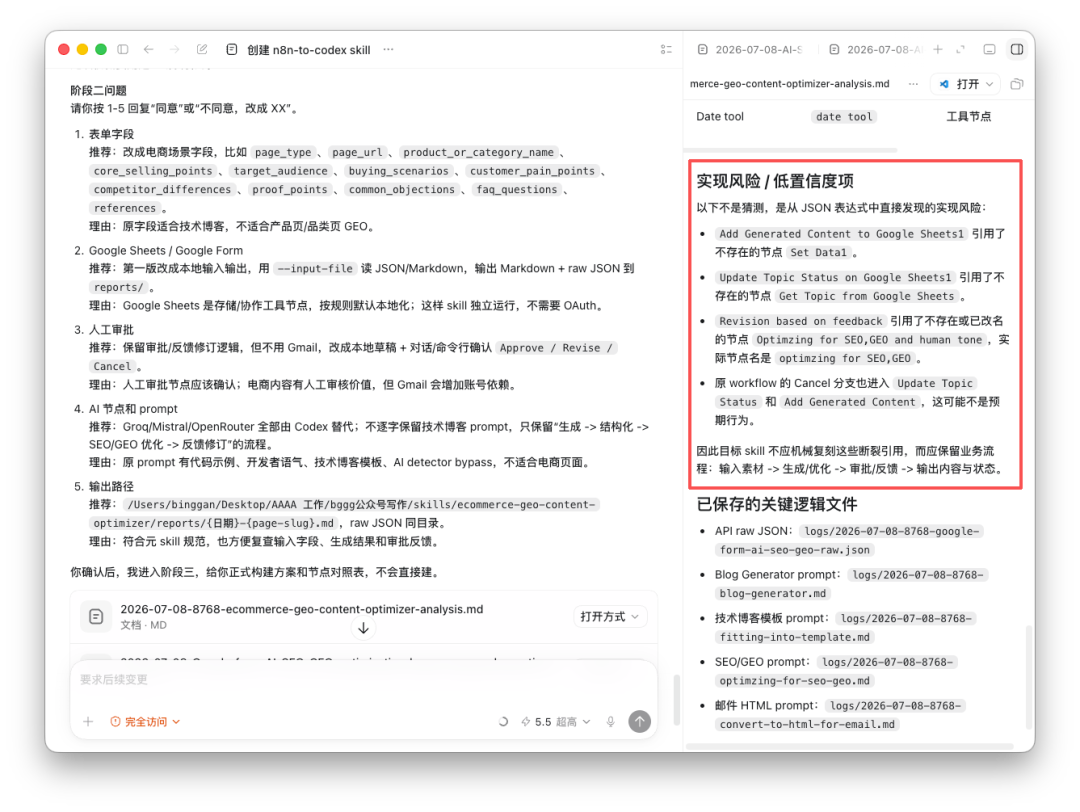
Codex解析过程中发现bug:这个模板本身可能从来没有完整跑通过。好几处节点引用的是根本不存在的节点!!也就是模板库一万多个模板,但没人保证每一个都是跑通过的成品。
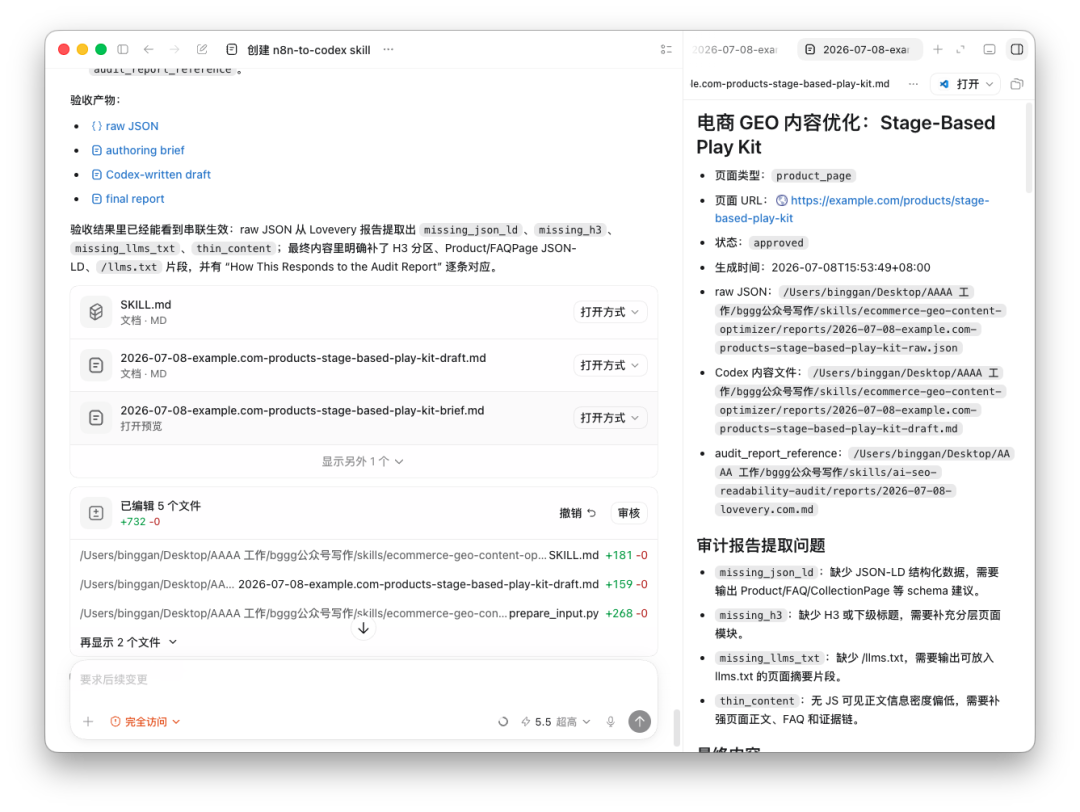
跑了一次验收,输入产品「Stage-Based Play Kit」,配上Lovevery的真实审计报告做参照。生成结果里有一节专门叫「How This Responds to the Audit Report」,逐条对应审计报告发现的四个问题。
- ✓划重点
串联机制是通的,但有个局限。
这个内容生成skill 能读取审计报告、能针对性生成内容、能逐条对应缺口。它没法证明、也没有办法证明,这些新写的内容真的会让ChatGPT多引用一次。。。
毕竟 AI 创作的内容没有客观标准、人来审核也是拿主观标准去评判。
- ✓Codex等
- ✓Agent
,到底是哪里真的比n8n强?
站得住脚的「更强」,有三处。
第一,能看出原系统的bug。
8768那个工作流,节点引用断裂,指向根本不存在的节点——Codex在解析阶段就抓出来了,不是等运行崩溃了才知道。n8n没有这个能力,它只会在跑到那个断点时报错。
第二,能在一次判断里,同时做确定和不确定的事。
审计skill的打分逻辑,长度、标签这些能钉死的部分交给规则引擎,摘要这类需要归纳的部分交给AI判断。n8n的节点要么是纯代码,全确定;要么是LLM节点,全黑箱。没有中间态。
- ✓第三,泛化能力。
一个n8n workflow只能干它自己那件事。这次的元技能,理论上能吃掉n8n.io那一万多个模板里的任何一个,自己解析、自己反问边界。这是「会自动化」和「学会怎么自动化」的差距。
- ✓老牌就是老牌
但有几处,n8n仍然更强,不能回避。
确定性和可审计性,n8n跑一百次同一个workflow,节点执行路径完全一致,出问题还能精确定位到哪个节点。Codex的skill是推理加规则的混合,长期大批量跑,一致性天然不如纯节点链路。
另外是集成桥接,n8n能连很多外部节点,配个凭证立马能用。Codex得现写脚本处理鉴权和数据格式。
需要判断、需要自我纠错的场景,Codex更强。需要成熟连接器、需要一眼看穿哪里出错的场景,n8n目前还是更合适的工具。
n8n没有死,是有些活,换了个更聪明的干法。
以上是「用 Codex 把 n8n 工作流转成 Skill:跨境电商案例」的全部拆解。
我们是海口曦东科技 Nexus-AI 团队——专注把 AI 真正落进企业业务:从诊断、试点到验收陪跑,每一步交付都有书面验收单。
如果你也在研究某个 AI 能力怎么接进自己的业务,欢迎聊聊,我们已经把可落地的第一步整理好了。